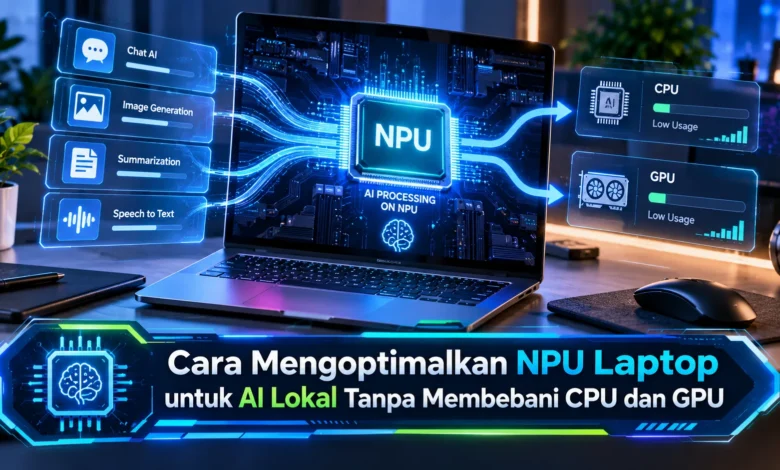
NPU atau Neural Processing Unit menjadi komponen yang semakin penting pada laptop modern karena dirancang untuk menangani beban kerja kecerdasan buatan secara lebih efisien. Dengan dukungan aplikasi dan konfigurasi yang tepat, sebagian pemrosesan AI lokal dapat diarahkan ke NPU sehingga CPU dan GPU tetap memiliki ruang untuk menjalankan tugas lainnya. Optimalisasi ini bukan sekadar mengejar kecepatan, tetapi juga memanfaatkan teknologi AI secara lebih efisien untuk menjaga performa, konsumsi daya, dan kenyamanan penggunaan laptop.
NPU Menjadi Komponen Penting untuk Pemrosesan AI Lokal
Hal pertama dalam mengoptimalkan NPU adalah memahami fungsi komponen tersebut. NPU dirancang untuk menjalankan tugas AI yang kompatibel dengan efisiensi komputasi yang sesuai untuk perangkat mobile. Jika dibandingkan dengan CPU serbaguna, NPU memiliki fokus pada akselerasi neural network yang didukung oleh perangkat lunak.
Hadirnya akselerator AI khusus tidak otomatis membuat seluruh aplikasi AI menggunakannya. Program dan lingkungan pemrosesan harus kompatibel dengan arsitektur NPU yang digunakan. Oleh sebab itu, pemilihan software menjadi bagian penting dari optimasi ketika pengguna ingin menjalankan AI lokal secara efisien.
Perbarui Driver dan Runtime agar NPU Terdeteksi Optimal
Driver yang tepat membentuk jembatan komunikasi antara sistem dengan akselerator AI. Menjaga driver sesuai rekomendasi vendor dapat mengatasi berbagai masalah integrasi sekaligus memberikan optimalisasi baru. Pemutakhiran sistem juga sebaiknya dilakukan secara berkala karena integrasi akselerator dapat ditingkatkan melalui versi sistem yang lebih baru.
Runtime AI juga berpengaruh terhadap penggunaan akselerator. Ketika software memiliki backend NPU yang kompatibel, beban kerja yang sesuai dapat diarahkan menuju NPU. Sebaliknya, runtime yang tidak kompatibel dapat membuat beban AI tetap diproses oleh prosesor atau grafis sehingga tujuan mengurangi beban CPU dan GPU tidak tercapai.
Gunakan Model Ringan untuk Pemrosesan AI Lokal
Berbagai model AI tidak selalu memiliki karakteristik yang sesuai untuk akselerator AI mobile. Model dengan kebutuhan memori tinggi dapat membutuhkan kapasitas komputasi yang lebih besar, sehingga beban komputasi tetap dapat jatuh pada komponen lainnya. Untuk penggunaan lokal, arsitektur AI yang lebih ringan biasanya lebih realistis digunakan.
Efisiensi arsitektur AI dapat mengurangi konsumsi memori. Pendekatan seperti kuantisasi dapat membantu menghasilkan model yang lebih ringan untuk perangkat tertentu. Akan tetapi pengguna sebaiknya memeriksa bahwa model yang digunakan sesuai dengan backend perangkat. Perpaduan model efisien dengan runtime kompatibel dapat membantu mengurangi keterlibatan CPU dan GPU.
Prioritaskan NPU untuk Beban AI yang Kompatibel
Distribusi tugas pemrosesan menjadi elemen yang perlu diperhatikan ketika perangkat menggunakan arsitektur komputasi heterogen. Pekerjaan komputasi konvensional dapat dijalankan melalui prosesor utama, sementara pekerjaan grafis dapat ditangani unit grafis. Operasi neural network yang didukung kemudian bisa ditempatkan pada akselerator AI.
Pembagian seperti ini dapat membantu mencegah satu komponen bekerja terlalu berat. Meski demikian setiap aplikasi belum tentu menyediakan pemilihan akselerator. Dalam beberapa software, sistem menentukan akselerator berdasarkan kompatibilitas. Oleh sebab itu, memilih aplikasi dengan backend NPU yang matang sering menjadi pendekatan yang lebih aman dan praktis.
Monitoring Sistem Membantu Menilai Efektivitas Optimalisasi NPU
Sesudah software dan model disiapkan, penggunaan hardware sebaiknya dipantau ketika fitur kecerdasan buatan digunakan. Langkah ini berguna untuk mengetahui apakah NPU benar benar menangani pekerjaan atau pemrosesan masih menggunakan prosesor utama atau grafis. Informasi tersebut dapat menjadi dasar untuk melakukan penyesuaian.
Ketika beban CPU tidak berkurang saat aplikasi AI aktif, situasi itu belum tentu menandakan konfigurasi salah. Tugas tertentu di luar inferensi tetap perlu dijalankan melalui prosesor, sedangkan unit grafis mungkin menangani operasi yang tidak didukung NPU. Tujuan yang lebih tepat adalah memanfaatkan setiap komponen berdasarkan keunggulannya, bukan menonaktifkan CPU serta GPU sepenuhnya.
Jaga Efisiensi Energi saat NPU Menjalankan AI
Manfaat penting Neural Processing Unit adalah kemampuannya menangani tugas tertentu dengan penggunaan daya yang efisien. Agar keunggulan ini tetap terasa, pengaturan daya sebaiknya disesuaikan dengan kebutuhan. Profil daya moderat dapat membantu mempertahankan efisiensi dalam penggunaan sehari hari, sementara pengaturan performa tambahan dapat diaktifkan sesuai kebutuhan aplikasi.
Temperatur perangkat juga berpengaruh terhadap kestabilan performa. Pastikan ventilasi tidak tertutup ketika menjalankan AI dalam waktu lama. Temperatur yang berlebihan dapat membuat komponen menyesuaikan kecepatan. Menjaga pendinginan yang baik membantu seluruh komponen mempertahankan performa secara stabil.
Kesimpulan Menjalankan AI Lokal Secara Lebih Efisien
Pemanfaatan NPU secara maksimal memerlukan kesesuaian antara perangkat keras, runtime, serta model AI. Driver yang sesuai, runtime kompatibel, dan model yang efisien dapat membuat distribusi beban komputasi menjadi lebih efektif. Pemantauan penggunaan komponen tetap diperlukan agar pengguna mengetahui apakah konfigurasi bekerja sesuai harapan. Melalui konfigurasi yang seimbang, teknologi NPU dapat membantu menghadirkan AI lokal yang lebih efisien tanpa memusatkan seluruh pekerjaan pada prosesor atau grafis. Anda dapat memantau pembaruan runtime dan aplikasi AI karena dukungan aplikasi dan model akan terus menentukan pemanfaatan akselerator AI.