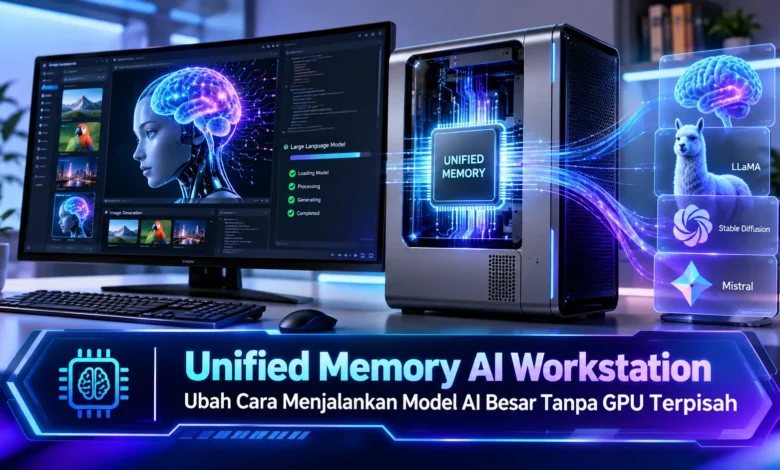
Unified Memory AI Workstation mulai menghadirkan pendekatan berbeda dalam menjalankan model kecerdasan buatan berukuran besar secara lokal. Alih alih selalu mengandalkan kartu grafis diskret dengan VRAM terpisah, arsitektur unified memory memungkinkan CPU, GPU terintegrasi, dan unit pemrosesan lain pada sistem yang mendukung untuk mengakses kumpulan memori bersama. Perkembangan teknologi ini menarik perhatian karena kapasitas memori yang besar dapat membuka ruang untuk menjalankan model AI yang sebelumnya sulit dimuat pada perangkat dengan VRAM terbatas, meskipun performa nyata tetap dipengaruhi bandwidth memori, kemampuan komputasi, optimasi perangkat lunak, serta karakter model yang digunakan.
Arsitektur Unified Memory Mengubah Cara Model AI Dimuat
Arsitektur memori bersama membawa konsep yang berbeda dibandingkan arsitektur dengan memori terpisah yang memisahkan RAM sistem dan VRAM. Pada workstation dengan arsitektur memori terpadu, CPU dan GPU terintegrasi dapat mengakses kapasitas memori terpadu untuk menangani data.
Konsep semacam ini semakin relevan untuk komputasi model AI secara lokal karena model dengan banyak parameter sering membutuhkan jumlah memori yang signifikan. Saat sistem menyediakan memori terpadu berkapasitas tinggi, model yang sulit dimuat pada VRAM terbatas berpotensi dapat dijalankan tanpa bergantung sepenuhnya pada GPU diskret kelas atas.
RAM Besar Menjadi Kunci untuk Memuat Model AI Lokal
Jumlah unified memory menjadi faktor utama ketika developer mencoba mengoperasikan model bahasa dengan banyak parameter. Parameter yang tersimpan perlu tersedia selama proses inferensi agar inferensi bisa berlangsung. Semakin besar model, semakin besar pula ruang memori yang dibutuhkan.
Pendekatan kompresi model seperti quantization berpotensi menekan konsumsi ruang memori dengan menggunakan presisi numerik yang lebih rendah. Namun, kapasitas memori yang besar tetap memberikan fleksibilitas untuk menjalankan model lebih besar. Perkembangan teknologi ini menjadikan kapasitas RAM menjadi bagian utama dari kebutuhan komputasi AI modern.
GPU Terintegrasi Tetap Berperan dalam Unified Memory Workstation
Istilah tanpa GPU terpisah penting untuk ditempatkan dalam konteks yang benar. Perangkat dengan arsitektur memori bersama umumnya tetap mengandalkan prosesor grafis yang terintegrasi untuk memproses workload tertentu. Perbedaannya, akselerator grafis terintegrasi tidak selalu menggunakan kumpulan memori terpisah dari RAM utama.
Dengan demikian, kemampuan menjalankan model AI besar bukan berarti kapasitas memori menjadi satu satunya faktor performa. Kemampuan GPU terintegrasi, bandwidth memori, kompatibilitas perangkat lunak, dan karakter workload tetap menentukan kecepatan inferensi. Kombinasi berbagai faktor tersebut menentukan hasil akhir dalam membangun workstation AI yang efektif.
Bandwidth Memori Menentukan Seberapa Cepat Model AI Bekerja
Menyediakan kapasitas memori yang luas memang membantu dalam memuat model AI, tetapi jumlah RAM semata tidak menjamin performa AI tinggi. Selama proses generasi, sistem terus memindahkan data yang diperlukan melalui subsistem memori.
Jalur data yang luas dapat membantu meningkatkan throughput pada proses inferensi yang bergantung pada memori. Sebaliknya, model yang dapat dimuat sepenuhnya belum tentu memberikan performa maksimal apabila bandwidth terbatas. Profesional yang membangun sistem AI lokal karena itu perlu melihat kapasitas dan bandwidth secara bersamaan.
Unified Memory Workstation Mendukung Lebih Banyak Pekerjaan Lokal
Kemampuan menjalankan AI secara lokal menghadirkan pilihan penggunaan yang lebih luas bagi pengembang. LLM yang dijalankan di perangkat dapat digunakan untuk mempercepat pekerjaan pengembangan, menganalisis informasi, membantu pencarian pengetahuan, hingga melakukan eksperimen kecerdasan buatan.
Profesional kreatif juga bisa menggunakan sistem komputasi AI untuk workflow visual, fitur kecerdasan buatan untuk audio, dan berbagai pekerjaan kreatif yang telah dioptimalkan untuk hardware tersebut. Menjalankan AI di perangkat juga berpotensi menekan ketergantungan pada koneksi internet, meskipun cloud tetap berguna untuk workload tertentu.
AI Lokal Berkapasitas Besar Semakin Mudah Diakses
Evolusi workstation dengan memori bersama memperlihatkan bahwa komputasi AI personal tidak selalu harus bergantung pada konfigurasi GPU diskret. Arsitektur yang lebih terintegrasi memberikan pilihan untuk menampung workload AI berukuran tinggi dalam sistem yang lebih ringkas.
Namun, keputusan menentukan workstation tetap harus disesuaikan dengan karakter workload. Komputer AI terintegrasi dapat memberikan keseimbangan yang baik untuk workload tertentu, sedangkan kartu grafis khusus berperforma tinggi dapat tetap lebih sesuai untuk komputasi dengan kebutuhan throughput tinggi. Perkembangan teknologi pada akhirnya memperluas opsi kepada pengguna untuk menyesuaikan perangkat dengan kebutuhan.
Kesimpulan Menjalankan Model AI Besar dengan Unified Memory
Unified Memory AI Workstation membawa pendekatan menarik untuk menjalankan model AI besar tanpa selalu membutuhkan GPU diskret. Ruang memori terpadu yang luas dapat membuka fleksibilitas dalam menjalankan AI lokal, tetapi kecepatan akses memori, performa akselerator, dan dukungan framework tetap sangat penting. Tren teknologi ini memberikan alternatif menarik bagi developer dan kreator yang membutuhkan workstation untuk kecerdasan buatan. Ceritakan perspektif Anda mengenai Unified Memory AI Workstation dan jenis model apa yang ingin Anda jalankan secara lokal.